lunes, 3 de marzo de 2014

Cabecera fija en una página web con CSS

1. Las cabeceras fijas en aplicaciones web y de escritorio

Muchas aplicaciones web presentan una serie de botones, titulares y menús que por diversos motivos han de estar siempre a la vista del usuario, aunque este haga scroll para mostrar contenidos que estén más abajo. Esta parte fija se suele dejar como una cabecera al principio de la página o una barra de enlaces o botones a la izquierda (en algunos casos, como Blogger, también a la derecha, o como Gmail, tanto en la cabecera como a la izquierda). Eso permite moverse por los datos manteniendo los botones para las acciones más habituales al alcance de la vista todo el rato. Como se entenderá mejor con una imagen, os muestro cómo se ve esto en el caso de Gmail:

Imagen 1. Cabeceras y barras de menú laterales fijas en aplicaciones web

Muchas otras aplicaciones tanto web como de escritorio también hacen cosas parecidas. Por ejemplo, en Twitter (al menos en su versión para Android) también ocurre así, aunque en este caso no se trate de una aplicación web, sino de escritorio). Aplicaciones de escritorio como Excel y Calc también permiten dejar fijas unas celdas de la hoja para que estén siempre visibles, arriba y/o a la izquierda.

El caso es que me interesaba hacer algo así para una página web que estoy haciendo y, ya que estoy intentando utilizar el CSS de una manera un poco más sistemática de lo que lo he venido haciendo hasta ahora, quería hacerlo con esta técnica.

2. Planteamiento

En mi caso, quería un diseño de página donde se quedara fija una cabecera siempre visible que tuviera tres partes:

- A la izquierda, espacio para un logo
- En el centro, tres líneas de texto informativo al usuario
- A la derecha, uno o varios iconos con botones y/o enlaces

Vamos, algo parecido a esto:

Imagen 2. Qué queremos conseguir

La solución: secciones (div) en la página

La solución a la que he llegado ha consistido en definir 4 bloques o divisiones (<div>) en la página (pagina1.php):

1) Una división para el rectángulo que contiene a los otros tres elementos
2) Una división para el logotipo
3) Una división para el texto informativo (en este caso, para las 3 líneas)
4) Una división para los botones de acción

Más o menos, algo así:

 1 <?php
 2 $modname = "PAGINA1"; 
 3 $modversion = "E31"; 
 4 $moddescri = "Descripción de la página 1";
 5 $linea1 = "<h1>" . $modname . " - versión " . $modversion . "</h1>";
 6 $linea2 = "<h2>" . $moddescri . "</h2>";
 7 $linea3 = "<h3>" . date("d/m/Y",time()) . "</h3>";
 8 $logo   = "img/logo_pagina1.jpg";
 9 ?>
10 <div id="rectangulo_fondo"> 
11     <div id="logo"> 
12         <img src="<?php echo $logo; ?>" height=100 alt="Logo" title="Logo"/>
13     </div> <!-- fin logo -->
14     
15     <div id="textos-cabecera"> 
16         <?php echo $linea1 . $linea2 . $linea3; ?>
17     </div>
18     
19     <div id="opciones-derecha">
20         <a href="ref1.htm" target=_blank><img src="img/info.png" title="Opción imagen"></a>
21         <a href="ref1.htm" target=_blank><img src="img/info.png" title="Opción imagen"></a>
22         <a href="ref1.htm" target=_blank><img src="img/info.png" title="Opción imagen"></a>
23     </div> 
24 </div>  <!-- fin rectangulo_fondo -->

(Como veréis, he parametrizado en variables la ruta hacia el logo y las tres líneas de información textual a mostrar, pero también podría haber puesto un contenido fijo).

Después de esto, he creado otro bloque con el resto de la información a mostrar, en este caso, 100 líneas de texto sin ningún sentido, pero suficientes para ilustrar lo que quiero hacer:

 1 <div id="bloque1">
 2 
 3 <?php
 4     for ($i=0; $i<100; $i++) {
 5         echo "<h1>Línea de texto número $i</h1>";
 6     }
 7 ?>
 8 
 9 </div> <!--bloque1-->

Si miramos ahora el aspecto de la página, sin haber creado aún el CSS, veremos algo así:

Imagen 3. La página sin CSS

Aplicando las hojas de estilos (CSS)

Feo, ¿verdad? Pero ahora entra en funcionamiento la magia del CSS. Vamos a indicar el color que queremos para el rectángulo de fondo (aquí he puesto un verde oliva), un borde para la parte inferior del rectángulo, una altura y un ancho:

 1 /* el rectángulo de fondo de la cabecera */
 2 #rectangulo_fondo {
 3     background: #e8e8a0; /* propiedad en modo shorthand, color verde oliva */
 4     border-bottom:1px solid #DDD;
 5     height: 100px !important;
 6     width: 100%;
 7 }

La altura de 100 píxeles que he establecido para mi rectángulo la he determinado por prueba y error, comprobando que es espacio suficiente para albergar las tres líneas de texto informativo que he establecido. Esto dependerá del formato que elijáis para vuestro texto, en mi caso he definido estos tres estilos:

 1 h1 {
 2     font-family: verdana,helvetica;
 3     font-size: 18px;
 4     font-weight: bold;
 5     color: #bb3902;
 6 }
 7 h2 {
 8     font-family: verdana,helvetica;
 9     font-size: 15px;
10     font-weight: bold;
11     color: #bb3902;
12 }
13 h3 {
14     font-family: verdana,helvetica;
15     font-size: 12px;
16     color: #000000;
17 }

Si usáis fuentes y/o tamaños diferentes, es posible que tengáis que establecer un poco más o un poco menos de altura a la cabecera.

Por otro lado, el ancho lo he establecido al 100% del ancho de la página, ya que quiero que la cabecera vaya de izquierda a derecha ocupando todo el frontal.

Si visualizáis la página ahora mismo, se verá mal. Las 3 líneas informativas se mezclan con las líneas de datos. Para evitar esto, indicaremos que el logo será flotante y esto hará que la sección que contiene a las líneas informativas ("textos-cabecera") se pegue al logo.

 1 #logo {
 2     float: left;
 3 }

El resultado hasta ahora es este:

Imagen 4. Esos iconos, a la derecha, ¡ARRRR!

Hmmm... vamos mejorando algo, pero nos interesa que los botones de acción se queden a la derecha. Para ello

 1 #opciones-derecha {
 2     float: right;
 3 }

Lo que nos deja un resultado así
Imagen 5. Los iconos de la derecha están que se arrastran. ¿Podríamos subirles el ánimo un poco?

Vaya, casi. Nos falta que queden arriba. Para conseguir esto, tenemos que indicar que el bloque con las 3 líneas de texto sea un bloque "inline", es decir, que se muestre en línea con el contenido que le precede y con el que va detrás. Es decir, ponemos

Y entonces se visualiza así:

 1 #textos-cabecera {
 2     display: inline-block;
 3 }

Imagen 6. Ya está todo en su sitio


Vale, esto casi está. Sin embargo, si hacéis el scroll de la página, comprobaréis que la cabecera, que tan chula nos ha quedado, se nos pierde por arriba.

Imagen 7. ¿A dónde vas, cabecera?

Necesitamos que no se mueva la cabecera y sí lo haga el bloque de líneas de datos. La clave es indicar que el bloque de cabecera debe quedarse FIJO. Esto se consigue con el atributo

 1 position: fixed;

Y ahora, al hacer el scroll, ya se queda la cabecera visible todo el rato
Imagen 8. Cabecera fijada

¿Hemos terminado? Pues no, aún nos quedan unos detalles importantes. Fijaos que al abrir la página, el bloque1, que contiene las líneas de datos, no se ve desde el principio. Las primeras líneas quedan ocultas por la cabecera

Imagen 9. ¿Dónde están las líneas 0, 1 y 2?

Para corregir esto, como sabemos que la cabecera tiene una altura de 100 píxeles, podemos establecer un margen superior para el bloque1 a partir de 110 píxeles.

 1 #bloque1 {
 2     margin-top: 110px;
 3 }

¿Se verá ahora bien?

Imagen 10. Ese hueco encima de la cabecera me hace sentir "vacío"

Pues no. Resulta que la cabecera se ha "arrastrado" hacia abajo. ¿Cómo podemos dejarla fija arriba? Pues estableciendo su propiedad "top" de forma que quede pegada al borde de la pestaña del navegador. O sea,

 1     top: 0 !important;

Y ahora se ve así:

Imagen 11. Bien, Pepe, bien. Ahora casi que sí.


Bueno, ahora sí. Y podemos comprobar el scroll y ver que la cabecera se queda fija.

Últimos detalles

Por último, sólo nos quedarían pequeños detalles, como que el borde izquierdo de la cabecera se pegue a la ventana del navegador (ese pequeño margen blanco a la izquierda no me gusta nada), cosa que conseguiremos con un
 1 left: 0;

Y que el texto informativo se quede centrado, lo que conseguiremos con

 1 text-align: center;

y además, indicando que el texto ocupe un amplio porcentaje del espacio de la cabecera

 1 width: 75%;

Si no hiciéramos esto último, el texto se centraría únicamente en el espacio mínimo reservado para él. Para mostrarlo, voy a pintar el fondo de este bloque de otro color

 1 background: #a8e8aa;

Y mostraremos cómo queda cuando no especificamos ancho
Imagen 12. Centrado, sí, pero en un espacio lateral


Y cuando sí lo hacemos al 75%

Imagen 13. Centrado en la franja central (el 75% de la cabecera)

Si somos muy estrictos, podemos ver que en realidad podríamos establecer un poco más del 75% como ancho de la zona de texto informativo, pues queda un pequeño espacio hasta el primero de los botones de acción de la derecha. Tampoco he querido esmerarme más ya que dependiendo del número de opciones que tengamos a la derecha, esto puede que haya que ajustarlo a un poco más o un poco menos, así que creo que es mejor hacer los ajustes en cada caso concreto.

Todo junto

Bueno, ya podemos volver a dejar el color del fondo como estaba y dar por terminada la página.

Esta página se puede utilizar como plantilla para aquellas páginas en las que necesitemos dejar una cabecera fija. Yo así lo voy a hacer, así que añadida queda a mi repertorio de plantillas. ¡Pa la saca!

Aquí os dejo el HTML completo y el CSS

El HTML
 1 <?php
 2 $modname = "PAGINA1"; $modversion = "E31"; $moddescri = "Descripción de la página 1";
 3 ?>
 4 <!DOCTYPE HTML PUBLIC "-//W3C//DTD HTML 4.01 Transitional//EN" "http://www.w3.org/TR/html4/loose.dtd">
 5 <html>
 6 <head>
 7     <meta http-equiv="Content-Type" content="text/html; charset=utf-8">
 8     <link rel="stylesheet" id="style-css" href="pagina1.css">
 9     <title><?php echo $modname . " - " . $modversion; ?></title>
10 </head>
11 <body>
12 <!--cabecera frente1-->
13 <?php
14 $linea1 = "<h1>" . $modname . " - versión " . $modversion . "</h1>";
15 $linea2 = "<h2>" . $moddescri . "</h2>";
16 $linea3 = "<h3>" . date("d/m/Y",time()) . "</h3>";
17 $logo   = "img/logo_pagina1.jpg";
18 ?>
19 <div id="rectangulo_fondo"> 
20     <div id="logo"> 
21         <img src="<?php echo $logo; ?>" height=100 alt="Logo" title="Logo"/>
22     </div> <!-- fin logo -->
23     
24     <div id="textos-cabecera"> 
25         <?php echo $linea1 . $linea2 . $linea3; ?>
26     </div>
27     
28     <div id="opciones-derecha">
29         <a href="ref1.htm" target=_blank><img src="img/info.png" title="Opción imagen"></a>
30         <a href="ref1.htm" target=_blank><img src="img/info.png" title="Opción imagen"></a>
31         <a href="ref1.htm" target=_blank><img src="img/info.png" title="Opción imagen"></a>
32     </div> 
33 </div>  <!-- fin rectangulo_fondo -->
34     
35 <div id="bloque1">
36 
37 <?php
38     for ($i=0; $i<100; $i++) {
39         echo "<h1>Línea de texto número $i</h1>";
40     }
41 ?>
42 
43 </div> <!--bloque1-->
44 </body>
45 </html>


El CSS
 1 h1 {
 2     font-family: verdana,helvetica;
 3     font-size: 18px;
 4     font-weight: bold;
 5     color: #bb3902;
 6 }
 7 h2 {
 8     font-family: verdana,helvetica;
 9     font-size: 15px;
10     font-weight: bold;
11     color: #bb3902;
12 }
13 h3 {
14     font-family: verdana,helvetica;
15     font-size: 12px;
16     color: #000000;
17 }
18 
19 /* el rectángulo de fondo de la cabecera */
20 #rectangulo_fondo {
21     background: #e8e8a0; /* propiedad en modo shorthand, color verde olivoso */
22     border-bottom:1px solid #DDD;
23     height: 100px !important;
24     /* para que permanezca la cabecera al hacer scroll */
25     position: fixed;
26     top: 0 !important;
27     left: 0;
28     width: 100%;
29 }
30 
31 #logo {
32     float: left;
33 }
34 
35 #textos-cabecera {
36     display: inline-block;
37     text-align: center;
38     background: #a8e8aa;
39     width: 75%;
40 }
41 
42 #opciones-derecha {
43     float: right;
44 }
45 
46 #bloque1 {
47     margin-top: 110px;
48 }

Pues nada, si os viene bien esta plantilla ya la tenéis explicada en detalle.

Y tú, ¿tienes alguna otra plantilla interesante para hacer cabeceras o barras de opciones laterales que se queden fijas? ¿La compartes con nosotros?

martes, 4 de febrero de 2014

Las mejores inyecciones son chorizos y jamones (parte 4, última)

4. Qué se puede hacer

Hasta aquí, hemos visto algunos ejemplos muy sencillos de cómo se puede intentar inyectar código SQL en una aplicación web (ojo: esto también sirve para una aplicación de escritorio). Pero, ¿hay algo que la madre de Caperucita pueda hacer para que el lobo no le putee la base de datos con una inyección SQL?

Bueno, no hay una solución mágica, pero se pueden hacer algunas cosas que sirven como pequeñas ayudas. Entre unas cosas y otras, se puede mitigar algo el poder de los ataques. Vamos allá. Seguro que a algunos se os ocurren más, pero estas son algunas de las actuaciones más básicas.

4.1 Instrucciones SQL precompiladas (prepared statements)

En primer lugar, está el uso de instrucciones SQL preparadas o precompiladas (prepared statements). Esto depende tanto del lenguaje (los más utilizados soportan todos formas más o menos parecidas de hacerlo) como de la BD. Estas instrucciones preparadas son como consultas precompiladas en las que lo único que falta es rellenar algunos datos que se han establecido como parámetros. Al estar precompiladas, estas instrucciones sólo se analizan (parsing) una vez, y se gana velocidad de ejecución, ya que el motor de la BD puede optimizar la consulta cuando se compila.

Pero lo mejor de ellas, para el caso que nos ocupa, es que los parámetros son gestionados por el motor de la BD; no tenemos que componer la sentencia SQL concatenando partes fijas con los parámetros. Bien es cierto que el motor también puede cometer un fallo, pero, seamos realistas, me fío más del equipo de programadores del motor de la BD y de su sistema de revisión que de mí, aunque nada más sea por el tamaño del equipo que tiene que haber detrás de un motor como SQL Server, Oracle o MySQL, por poner algunos. Y mira que yo soy buen programador (y además, guapo), pero aún y con esas, no creo que les gane ;-)

El caso es que los parámetros normalmente tienen tipos (integer, string...) que son comprobados por el motor y eso facilita mucho evitar que se cuelen cosas "raras".

En el caso de PHP, que es el que me pilla más cercano ahora, las instrucciones preparadas se pueden utilizar con los PDOs. Más info aquí:
http://php.net/manual/en/pdo.prepared-statements.php

4.2 Sanear la entrada

Otra cosa que se puede hacer es analizar la entrada que está metiendo el usuario para ver si contiene caracteres raros. Por ejemplo, si en el campo donde espero leer un NIF me encuentro algo que no son dígitos ni letras, ¡alarma! Como norma general, se pueden validar campos habituales como el NIF, los apellidos, el nombre, etc... para alertar si contienen comillas, exclamaciones, barras, etc... Se puede funcionar por lista negra (un conjunto de caracteres prohibidos) o, mejor aún (en mi opinión), si se sabe de antemano, funcionar por lista blanca (conjuntos de caracteres permitidos). En un apellido no permitiría ni siquiera un dígito. No obstante, a veces habrá que permitir la comilla (se me ocurren apellidos como O'hara) y en particular hay que tener cuidado con las codificaciones de los caracteres con tildes, eñes, etc...

4.3 Permisos en la BD

Bueno, si a pesar de nuestras precauciones el atacante logra ejecutar una instrucción contra la BD, intentemos que al menos el daño sea el menor posible. Siguiendo el principio de mínimo privilegio, un usuario nunca debería tener más permisos de los estrictamente necesarios para realizar su labor. Si sólo va a consultar datos en la BD, no tiene por qué tener permisos para cargarse una tabla. De esta forma, aun en el caso de que un atacante consiguiera inyectar una instrucción del tipo "drop table", si la ejecución se lleva a cabo con los permisos de un usuario con acceso de sólo lectura, ésta fallaría.

Así que ya sabéis, para configurar bien los permisos, a revisar aquello del GRANT SELECT ON TABLA... para el caso específico de vuestra BD.

Principio del mínimo privilegio:
http://sophosiberia.es/principio-de-minimo-privilegio-reducir-el-area-de-ataque/

4.4 Otras pequeñas ayudas

Por último, hay algunas otras cosas que se pueden hacer que, aunque no son la panacea, pueden aportar su granito de arena.

4.4.1) Limitar el tamaño de los campos de entrada. 

Por ejemplo, los login de los usuarios. En entornos empresariales a veces hay reglas cuadriculadas para asignar los login (así ocurre en uno de los entornos en los que suelo trabajar). Si los nombres de usuarios no superan los 10 caracteres, por ejemplo, limitar el tamaño de ese campo puede contribuir a que desde el formulario no se puedan insertar peticiones con instrucciones largas (por ejemplo, no se podría insertar el DROP TABLE...). Esto no evita que se lance una petición a través de un programa elaborado específicamente para ello, pero dificulta un poco la realización de ataques.

2) Registrar lo que se ejecute

También puede ser conveniente llevar un registro (tabla de log, fichero, log del sistema...) con las operaciones que se van realizando desde los programas. Esto no va a evitar que se produzcan los problemas, pero al menos puede ayudar para, una vez producidos y detectados los mismos, determinar el origen (usuario, dirección IP...) y por lo menos saber por dónde buscar para intentar cazar al lobo. Si no hemos podido evitar el ataque, al menos nos queda el consuelo de intentar pillar al responsable y darle un capón.

3) Filtros por palabras

Se pueden filtrar determinadas palabras clave en las entradas del usuario (como "drop", "delete"...) en determinados campos donde esto no tiene sentido. Por ejemplo, normalmente no encontraremos nombres o apellidos con esas palabras, así que si un usuario se llama "Drop..." lo mínimo que se puede hacer es disparar una alerta y llamar al leñador, a que venga con el hacha.

4) Codificaciones de cadenas

Esta solución no la he probado, pero la vi apuntada en un foro y quizás merezca dedicarle un poco de atención. La idea es codificar las entradas del usuario haciendo una conversión de las cadenas de entrada a codificaciones puras ASCII.

Lo que se argumenta es que con estas codificaciones desaparecen las comillas, los puntos y coma y otros caracteres "peligrosos". Pero no tengo muy claro cómo se harían las búsquedas y comparaciones. En fin, ahí os dejo apuntados los nombres de las funciones que habría que mirar, para aquellos que deseéis investigar: base64, hex2bin, unhex, pack...

Aquí lo dejo

Bueno, con esto doy por zanjado el tema. Como veréis, la metáfora del cuento de Caperucita ha ido perdiendo fuerza con cada nueva entrada; fue una chorrada que se me ocurrió un día y después me ha dado un poco de pereza mantenerla, aunque ahí la dejo por si alguien quiere elaborar un poco sobre ella y darle mejor forma.

Por otro lado, como ya he dicho otras veces, estas entradas las escribo, en primer lugar, para mí, por lo que a veces puede que dé por supuestas ciertas cosas y no me esfuerce en explicar las bases, aunque creo que cualquier programador con un nivel básico puede seguir las explicaciones sin complicaciones. En este caso, apenas he tocado la punta del iceberg del tema en cuestión, pero a mí me bastaba con tener unas pruebas de concepto que funcionaran realmente, y lo he conseguido, así que al menos a mí me ha valido. El hecho de haberme obligado a escribir de forma más o menos estructurada me ha generado, como otras veces, más preguntas que respuestas, y un montón de ideas y tareas a realizar, así que ahora me toca dedicarme a implementar muchas de las ideas que han ido apareciendo durante la escritura de esta serie de entradas, así como hacer pruebas reales en mis aplicaciones, pues me he dado cuenta de algunos fallos que tengo que debería corregir cuanto antes.

Para eso me sirve escribir ;-)

Referencias

Aquí tenéis el enlace a todos los artículos anteriores de la serie:

Parte 1
http://cosicasdeinformatica.blogspot.com.es/2014/01/las-mejores-inyecciones-son-chorizos-y.html

Parte 2
http://cosicasdeinformatica.blogspot.com.es/2014/01/las-mejores-inyecciones-son-chorizos-y_23.html

Parte 3
http://cosicasdeinformatica.blogspot.com.es/2014/01/las-mejores-inyecciones-son-chorizos-y_27.html

lunes, 27 de enero de 2014

Las mejores inyecciones son chorizos y jamones (parte 3)

3.2 Haciendo daño (DROP TABLE)

Preguntémonos ahora si sería posible llevar al cabo el caso del DROP TABLE descrito en el apartado 1.

Imaginemos que el atacante no sabe el nombre de las tablas de nuestra BD. Para ilustrar qué pasaría en este caso, primero probaremos con una tabla que no exista introduciendo en el nombre de usuario la expresión

' or '1'='1'; drop table kk2--

Y al pulsar el botón "Entrar" obtenemos


Imagen 3.1 Intentando eliminar una tabla inexistente

Bueno, no sabemos si ha funcionado el DROP TABLE o ha fallado, pero sí sabemos que no se produce ningún mensaje de error. El atacante podría ir haciendo pruebas por fuerza bruta, hasta encontrar una tabla que sí exista. Para probarlo, he creado en la BD una tabla "kk" y quiero ver si se elimina y se me notifica de ello. He repetido la prueba

Imagen 3.2 Intentando eliminar una tabla que sí existe

Como véis, ningún mensaje de error o éxito. Pero al comprobar si  la tabla sigue viva me encuentro con (...redoble de tambores...)

¡Vaya, ha desaparecido! (bueno, aquí no tengo una imagen para ilustrar esto, pero tendréis que creerme, es que un pantallazo en este caso no aporta nada).

Hmmm... peligro, peligro...

En este caso, el atacante no sabe si su técnica ha funcionado, pero si lo que le interesa simplemente es hacer daño, no le sería demasiado complicado realizar un script que fuera generando por fuerza bruta todas las combinaciones de nombres entre 1 y 30 caracteres (pongamos por caso) y cargarse nuestra BD completa. Vale que esto llevaría un buen rato, pero el lobo tiene tiempo libre y ganas de fastidiar.

Según he leído (esto no lo he probado), la ejecución de dos sentencias SQL en una única llamada a la función correspondiente no funciona con todas las BBDD. Según dicen, en MySQL no funcionaría. Pero yo acabo de comprobar que en SQL Server sí funciona, así que ¡CUIDADÍN!

3.3 Meter basura en casa (INSERT INTO)

Continuando con nuestras pruebas, imaginemos por un momento que el atacante sabe el nombre de la tabla de usuarios y los campos, al menos el del nombre del usuario y el del hash de la clave (login y epass, respectivamente, en nuestro ejemplo). Pensar que un atacante sabe tanto no es descabellado, pues es relativamente sencillo forzar errores que, si no se gestionan bien (casi nunca se gestionan bien al 100%) revelan algunos de estos datos. Más adelante veremos algunos ejemplos sobre formas de obtener información acerca de la BD, como nombres de tablas, campos, etc...

En ese caso, podría intentar insertar un registro que le proporcione una cuenta de usuario. Algo así como:

' or '1'='1'; insert into usuarios(login, epass) values ('lobito', 'x')--

Donde 'x' sería el valor hash de la clave que él desea ponerse. Vale, aquí quizás estamos suponiendo ya demasiado, como que se utiliza un algoritmo u otro (MD5, SHA1...) para calcular el hash, pero tampoco esto es descabellado. Además, utilizar una "sal" (salt) para la contraseña dificultaría el ataque, pero de momento seguimos con ejemplos en entornos más o menos sencillos.

Bien, pues introducida la expresión que he puesto, pulsamos Entrar y...

Imagen 3.3 Nos la han colado doblada

¡Vaya, ahí está el registro insertado!

Que luego esa información le sea más o menos útil al lobo en su lucha contra la Caperumadre es otra cosa, pero el caso es que ya ha conseguido introducir datos ficticios, basura, en la BD. ¡Hmmm, malo, malísimo!

La semana que viene continuaremos.

Referencia:

Las mejores inyecciones son chorizos y jamones (un cuento de inyección SQL). 

Parte 1
http://cosicasdeinformatica.blogspot.com.es/2014/01/las-mejores-inyecciones-son-chorizos-y.html

Parte 2
http://cosicasdeinformatica.blogspot.com.es/2014/01/las-mejores-inyecciones-son-chorizos-y_23.html

jueves, 23 de enero de 2014

Las mejores inyecciones son chorizos y jamones (parte 2)

En la parte 1 hablé de la teoría; ahora vamos a montar un entorno básico y a hacer algunas pruebas, a ver si lo que allí se contaba es así realmente.

2. Un entorno de pruebas

Para tener un entorno de pruebas, crearé dos páginas PHP, una con el formulario de solicitud de datos y otra con el resultado del procesamiento. Probablemente, en una aplicación real esta página sea la misma, o no, pero de momento estamos haciendo algunas pruebas "de juguete".

 1 <html>
 2     <head>
 3         <meta http-equiv="Content-Type" content="text/html; charset=utf-8">
 4         <title>Pruebas SQL Injection</title>
 5     </head>
 6 <body>
 7     <h1>Introduzca usuario y contraseña</h1>
 8     <form action="test2_res.php" method=POST target=_blank>
 9         Usuario <INPUT TYPE="text" NAME="usuario" SIZE=20 MAXLENGTH=20>
10         <br>
11         Contraseña <INPUT TYPE="password" NAME="pwd"   SIZE=20 MAXLENGTH=20>
12         <br>
13         <INPUT TYPE="submit" CLASS="boton" VALUE="Entrar">
14     </form>
15 </body>
16 </html>
Listado 2.1. La página de prueba

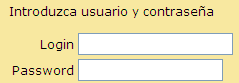
que se ve más o menos así (con variaciones mínimas entre navegadores):

Imagen 2.1 Como véis, todo un derroche de diseño y buen gusto.

Y la parte de procesamiento en la página 2 podría ser algo más o menos así:

 1 <?php
 2     //...otras cosas
 3     
 4     $conn = conectar_bd(); //falta control de errores
 5     $usuario = $_POST['usuario'];
 6     $pwd     = $_POST['pwd'];
 7     $epwd    = strtoupper(md5($pwd));
 8     echo "Datos leídos '$usuario' y '$pwd' -->encriptada: '$epwd'<br>";
 9     $sql = "select login, epass from usuarios where login = '$usuario' and epass = '$epwd'";
10     $rs=odbc_exec($conn, $sql);
11     if (!$rs) {exit("Error en SQL");}
12     
13     $encontrados = 0;
14     while ($row = odbc_fetch_array($rs)) {
15         $encontrados++;
16         echo "encontrado registro " . $row['login'] . " " . $row['epass'];
17     }
18     
19     if ($encontrados == 0) {
20         echo "no se encontró el usuario";
21     }
22     
23     //... otras cosas
24 ?>
Listado 2.2. La página que procesa el login y la clave introducidos

Como habréis visto, si habéis leído el código (si no lo has hecho, vuelve unas líneas arriba y léelo antes de continuar), la clave no se almacena en claro, sino que se almacena su hash MD5, pero esto no cambia en nada la prueba de concepto y lo que hemos dicho hasta ahora (sólo añade un poco de realismo a la situación, ya que esto es algo habitual en sistemas reales). También veréis que el procesamiento se limita a listar todos los registros que se encuentren que cumplan la condición, que en principio es que coincida el login con el que ha introducido el usuario, y el hash de la contraseña introducida con el hash almacenado en el campo "epass" (e de encriptada). En un sistema real en producción, lógicamente este listado de los registros recuperados no se haría, pero para nuestras pruebas es más ilustrativo. También voy a mostrar la sentencia SQL que se ejecuta, ya que a efectos de muestra va a ser de ayuda para entender lo que está pasando por dentro, y el hash de la clave introducida, esto es simplemente porque durante las pruebas lo hice así y ahora no me apetece repetir las capturas de pantalla quitando esto.

Por otra parte, en la BD, montada sobre un servidor SQL Server, he dado de alta un usuario con nombre 'caperu' y contraseña 'reparto1'.

Primero insertamos un par usuario / clave normal y vemos que todo funciona como se espera:


Si introducimos una clave incorrecta:


Bueno, en apariencia todo funciona más o menos bien. Con esto ya tenemos el entorno de prueba montado. Manos a la obra.

3. Haciendo algunas pruebas

Ahora intentaremos probar casos similares al descrito en el apartado 1 para ver si conseguimos obtener el mensaje de acierto: "encontrado registro..."

3.1 ¿Es uno igual a uno?

En primer lugar, supongamos que el lobo está engandulado, y se limita a meter en el campo "usuario" la siguiente expresión:

' or '1'='1'--

y deja la contraseña en blanco (¿para qué teclear sin necesidad?). Le da a ejecutar... et voilà! (La explicación a por qué usar esta expresión está en la parte 1, así que no me voy a repetir aquí).


Vaya, esto pinta mal, ¿eh? El lobo malo ha conseguido revelar todos los nombres de los usuarios, incluyendo el de Caperucita (usuario "caperu"). Además, puede decir que ha entrado en la BD. Por supuesto, en un sistema real se comprobarían otras cosas, pero estamos trabajando con una prueba de concepto y el ejemplo ya nos permite atisbar algunos de los peligros de esta técnica.

Bueno, creo que hasta aquí ya está bien por hoy. Hemos montado un entorno de pruebas y esta primera prueba ha sido suficiente para tomar conciencia del problema. 

¿Qué pruebas se te ocurre que podría hacer el lobo a continuación? ¿Cómo podría la Caperumadre prevenirse contra esto? 

La semana que viene seguiremos con el tema...

Referencia:

Las mejores inyecciones son chorizos y jamones (un cuento de inyección SQL). Parte 1
http://cosicasdeinformatica.blogspot.com.es/2014/01/las-mejores-inyecciones-son-chorizos-y.html

martes, 14 de enero de 2014

Las mejores inyecciones son chorizos y jamones (un cuento de inyección SQL). Parte 1

Bien es verdad que hace casi 4 meses que no escribo en este blog, pero este año me he propuesto escribir un poco más que el pasado. Cosa que no será muy difícil, ya que el año pasado sólo escribí cinco entradas. De momento, he empezado con una serie que me dará para varias entradas.

lunes, 16 de septiembre de 2013

Limitar las conexiones a unas IPs conocidas

En cuestión de seguridad en nuestras aplicaciones web, toda precaución es poca. La seguridad cuesta dinero, (una vez oí la frase "$eguridad se escribe con $", y tiene toda la razón). O cuesta tiempo, que viene a ser lo mismo pero en otra divisa. Por eso, no se puede hacer un sistema inmune a todas las posibilidades de ataque, siempre habrá alguien con más tiempo libre (o más dinero) que nosotros que se dedique a sabotear nuestra web y termine consiguiéndolo antes o después. Y si no, pues ya llegará la NSA y sacará la información que le dé la gana.

Pero esto no significa que nos tengamos que rendir sin más. Por eso, hay que intentar poner todas las medidas que se puedan implantar con un esfuerzo razonablemente ajustado al proyecto en el que se está trabajando. Algunas medidas son muy eficientes, pero tan costosas en tiempo o dinero que resultan inviables. Otras, en cambio, no requieren un gran esfuerzo y, aunque no sean la panacea, ayudan. Así que hay que intentar incluir estas "medidas de pequeño esfuerzo" que, combinadas, ayudan a hacer de nuestra web un sitio un poco más seguro.

Una de estas pequeñas medidas, que sólo se puede aplicar en entornos muy controlados (por ejemplo, una intranet, donde conocemos cuáles son los equipos que se van a conectar) consiste en limitar las conexiones a nuestro servidor a unas determinadas direcciones IP. Es verdad que esta restricción es relativamente fácil de saltar, pero si así nos quitamos algún "moscón", pues bienvenida sea. Hace un par de meses, mi amigo M me envió el código para hacer esto en PHP, pero por diversos motivos hasta ahora no había podido probarlo (y eso que se hace en 5 minutos, ¿eh?). Así que no seáis como yo y si os gusta, integradlo en vuestra intranet cuanto antes. Yo ya lo he hecho, y desde hoy los usuarios sólo deberían poder conectarse desde las IPs que yo permita. La única modificación que he hecho ha sido que en vez de una única dirección IP válida, he creado un array de ellas ($vip = array de IPs válidas).

Paso al código, que ya está bien de palabrería. Lo único que hay que hacer es esta función:

 1 function chequear_ips() {
 2     $vip = array("10.15.x.y", "10.15.x.z"...);
 3     if (!in_array($_SERVER['REMOTE_ADDR'], $vip)) {
 4         header("HTTP/1.1 401 Unauthorized Access Denied");
 5         header("Location: http://www.google.es/");
 6         exit(1);
 7     }
 8 }

y a continuación, al principio de cada página que queramos tener con acceso limitado, invocar a esta función. Lo más habitual será incluirlo en un fichero general y hacer el include_once correspondiente. Como veréis, en la línea 2 se van añadiendo las direcciones IP a las que queremos dar acceso.

Facil, ¿verdad?

Ejercicio: ¿cómo podemos saltarnos esta restricción?

martes, 27 de agosto de 2013

Botón predeterminado en formularios con un sólo campo

Lo que sigue puede parecer una tontería, pero esta "tontería" me ha hecho perder casi dos horas haciendo pruebas y buscando por la web, además de hacerme maldecir en todos los idiomas que conozco y alguno inventado.

Y la solución la he encontrado por casualidad, así que podría haber sido peor. Aquí os lo pongo por si os pasa algo así.

PRIMER CASO


Supongamos que queremos desarrollar un formulario HTML con UN PAR DE CAMPOS, que será procesado por una página en PHP (por simplificar, voy a hacer que la misma página de acción sea la que contiene al formulario). La tarea parece fácil, ¿verdad? Algo así:

Página f1.php
 1 <html>
 2 <head>
 3 <title>Form con 2 campos</title>
 4 </head>
 5 <body>
 6     <form action='f1.php' method='post'>
 7         Dato 1 <input type='text' name='dato1'>
 8         Dato 2 <input type='text' name='dato2'>
 9         <input type='submit' name='submit' value='Enviar'>
10     </form>
11 <?php
12 if (isset($_POST['submit'])) {
13     $dato1 = $_POST['dato1'];
14     $dato2 = $_POST['dato2'];
15     echo "Datos [$dato1] y [$dato2]";
16 }
17 ?>
18 </body>
19 <html>

Como véis, he obviado el control de errores en los datos, si están vacíos, etc...

Ahora lo probamos insertando un par de datos y terminamos PULSANDO con el ratón el botón "Enviar". El resultado es el mensaje de nuestro maravilloso algoritmo:


Fig. 1: Maravilloso algoritmo

Si a alguien le parece más cómodo (a mí sí) pulsar la tecla INTRO al terminar de introducir el dato 2, observará que el resultado es exactamente el mismo. Es decir, al navegador tanto le da que pulsemos INTRO como que hagamos clic en el botón "Enviar". Hasta aquí todo bien.

SEGUNDO CASO

Ahora hagamos una copia de esta página con un pequeño cambio, eliminando el dato 2 y dejando el código como sigue:

Página f2.php
 1 <html>
 2 <head>
 3 <title>Form con 1 campo</title>
 4 </head>
 5 <body>
 6  <form action='f2.php' method='post'>
 7   Dato 1 <input type='text' name='dato1'>
 8   <input type='submit' name='submit1' value='Enviar'>
 9  </form>
10 <?php
11 if (isset($_POST['submit1'])) {
12  $dato1 = $_POST['dato1'];
13  echo "Dato [$dato1]";
14 }
15 ?>
16 </body>
17 <html>

Si al insertar el dato 1 hacemos clic en el botón "Enviar", todo funciona como antes:
Fig. 2: Maravilloso algoritmo simplificado

Pero si en vez de eso, hacemos la opción cómoda, o sea, pulsar INTRO al terminar de teclear el dato 1, resulta que la salida que obtenemos es, extrañamente, esta:

Fig. 3: ¡Juro por Snoopy que yo he pulsado INTRO!

Es decir, el resultado es exactamente igual que si no hubiera pulsado nada, y simplemente hubiera recargado la página sin enviar datos.

Hmmm... bien raro, ¿no? Visto ahora aquí, con este par de ejemplos tan sencillos, la cosa está más o menos clara y parece muy fácil, pero a mí me ha tenido loco un buen rato. Yo quería, por supuesto, por orgullo profesional, que, aunque la página funcionara haciendo clic sobre el botón, también existiera la opción de pulsar INTRO al teclear el dato. Y, claro, esto no estaba funcionando como yo esperaba.

LA PISTA DE LA EXPLICACIÓN

Tras un buen rato de búsqueda, y leer en veinte mil sitios cómo se hace un formulario HTML y cómo se procesa, he encontrado este texto que me ha dado la pista:

Fig. 4 El botón SUBMIT no siempre es necesario (oh my god!)

Supongo que esto vendrá en la especificación oficial de HTML. Aunque siempre se recomienda leerla, reconozco que hacerlo puede ser muy tedioso, y no es habitual que casi nadie lo haga. Normalmente aprendes HTML siguiendo algún curso o tutorial y los detalles los vas conociendo en aquellos aspectos específicos que te van haciendo falta. En mi caso, hasta ahora siempre había trabajado con formularios de dos o más campos, así que no me había encontrado antes con este problema.


Bien. Entonces, he comprobado que en ese caso, cuando el formulario SOLO TIENE UN CAMPO con datos de entrada, el botón "Enviar" no se establece a nada, es decir, la condición

if (isset($_POST['submit1']))

se hace falsa.

LA SOLUCIÓN

Obviamente, pues en vez de comprobar si se ha establecido algún valor para el botón submit (o como comprobación ADICIONAL, combinada en un OR con la anterior), se puede comprobar si se ha introducido algún dato en el único campo, es decir, algo así:

if (isset($_POST['dato1']))

Y esta condición ya sí que se hace cierta en el caso de que se pulse INTRO al terminar de escribir el dato. De hecho, he comprobado que si elimino el botón submit del formulario, al pulsar INTRO también se hace el envío POST. Hmmm, ¿sería buena idea no poner un botón "Enviar" en un formulario con un único campo de texto? Por un lado, la interfaz de usuario se simplifica al máximo, pero por otro, puede despistar... no sé.

¿Y tú? ¿Has estado alguna vez perdiendo el tiempo por tonterías tan insignificantes como esta? ¿Hay que leerse las especificaciones al detalle antes de ponerse a currar, o hay que darse estos "coscorrones" de vez en cuando y meterlos en esa bolsa que llamamos experiencia?

Si te apetece, deja tus comentarios.

martes, 4 de junio de 2013

Codificación de caracteres en páginas web

Las codificaciones de caracteres son un quebradero de cabeza. Cuando hago una página web y al abrirla en un navegador empiezo a ver caracteres "extraños", me da mucha rabia. Sobre todo, porque demuestra que algo se está haciendo mal, y normalmente suelo ser yo, y no el ordenador, quien se está equivocando.

Fig. 1. ¡Qué rabia me dan estas cosas! ¡Y qué impresión más cutre da uno como programador!

¿Qué codificación hay que utilizar: UTF-8, ASCII, CP-1252, ISO-8859-1, ISO-8859-15...? Esto es para volverse loco. O para comerse las cerillas, que diría Llopis.

Preguntando a la autoridad en esta materia, el World Wide Web Consortium (W3C), esta es la cuestión (ver http://www.w3.org/International/questions/qa-choosing-encodings.es.php, cuya lectura os recomiendo encarecidamente, es muy reveladora).

y un poco más abajo dan la respuesta


Lo mejor es configurar el editor con el que se está trabajando para que todos los documentos se generen con esta codificación. En mi caso, últimamente estoy trabajando con el editor Komodo, para PHP. Esto se codifica aquí:

Edit / Preferences

También hay que tener cuidado, ya que aparte de la configuración genérica (para todos los ficheros), también se puede establecer una configuración específica para un fichero individual, el fichero actual. Esto se puede comprobar en el menú Edit / Current File Settings

Y se configura en esta pantalla


A veces, no basta sólo con esto. También es importante añadir la cabecera META adecuada a la página. En el ejemplo de la página mostrada arriba (la de la contraseña), la ñ se visualizaba erróneamente a pesar de estar codificada en UTF-8, y de que el navegador me la reconociera como tal (lo que se puede comprobar en el menú Ver / Codificación, tanto en IE como en Firefox, aunque esto puede tener pequeñas variaciones dependiendo del navegador y su versión)


¿Qué faltaba, pues? Pues faltaba añadir en la sección <head> esta etiqueta

<meta http-equiv="Content-Type" content="text/html; charset=utf-8">

Una vez añadida, ahora ya se ve bien.

Si la página no es HTML, sino que se genera, por ejemplo, un Excel, hay que añadir la cabecera pero cambiando el atributo "content" en función del tipo de contenido. Por ejemplo, generando un XLS con PHP, hay que añadir:

header("Content-type: application/vnd.ms-excel charset=utf-8");

Conclusión: como dice el W3C, SIEMPRE QUE SEA POSIBLE, USE UTF-8. (Pero no te olvides de la etiqueta META correspondiente).

Por supuesto, esta es la respuesta simple. Hay que considerar otros casos particulares, como por ejemplo, tener que mostrar datos de una base de datos que no está en UTF-8. En ese caso, a lo mejor conviene cambiar la codificación de esa página en concreto, o bien convertir los resultados utilizando las funciones de conversión entre codificaciones.

Yo tengo ahora mismo ese problema. En la misma página (codificada en UTF-8, y con el META correspondiente) tengo que mostrar información procedente de diferentes bases de datos. Claro, con unos registros se me muestran bien las tildes y con otros no.


¿Será por el origen de la información, que viene de diferentes bases de datos? En efecto, parece ser que esa es la causa. Las BD están codificadas con diferentes codificaciones. Para resolver esto, o sea, para convertir a UTF-8 datos que no están en dicha codificación, tenemos en PHP la función utf_encode. En mi caso, usarla consiste en cambiar, donde dice

$s1=odbc_result($rs,"s1");

debe decir

$s1=utf8_encode(odbc_result($rs,"s1"));

Una vez hecho, ya se ven bien los resultados:

Bueno, estoy seguro de que voy a tener que seguir peleándome un poco con las codificaciones, pero obligarme a escribir esto me ha hecho comprender mucho más claro el problema y las soluciones.

¡Feliz programación!

Related Posts Plugin for WordPress, Blogger...