Mostrando entradas con la etiqueta oracle. Mostrar todas las entradas

martes, 9 de enero de 2018

Renumerar Secuencias en Oracle (ALTER SEQUENCE)

Uno de mis usuarios me ha notificado hoy un mensaje de error que le ocurre al insertar registros en una tabla. La operación de inserción da un error en la BD Oracle:

HY000 - 1 OCIStmtExecute: ORA-00001: restricción única (...) violada

Analizando la estructura de la tabla, veo que esta tiene como clave primaria un campo ID [NUMBER(7,0)], y que la operación de inserción obtiene el siguiente ID a insertar de una secuencia (CREATE SEQUENCE...). Esto me lleva a sospechar que probablemente el siguiente ID a insertar esté coincidiendo con algún ID ya existente en la tabla, cosa extraña tratándose de una secuencia, y que no debería  pasar, pero... ¡tantas cosas no deberían pasar y pasan!

Vamos con las secuencias en ORACLE.

El juego SEQUENCE


Para saber cuál será el siguiente valor que devolverá una secuencia, podemos hacer dos cosas:

1. Función NEXTVAL.


La instrucción

SELECT SEC_MI_SECUENCIA.nextval FROM dual;
=> 3601

nos devuelve el siguiente número de la secuencia. El único "problema" es que esta operación "consume" un valor de esa secuencia. Supongamos que me devuelve el valor 3601. Si vuelvo a ejecutar la operación, devolvería un nuevo valor, 3602 (asumiendo que la secuencia se incrementa en pasos de 1 unidad). Cada vez que se vuelva a ejecutar esa instrucción, estaré "gastando" un número de la secuencia. Así que, si este comportamiento no es deseable, cuidado. Esto puede ocurrir cuando tenemos tablas donde queremos TODOS los registros que se puedan ir insertando, como una tabla de registro de actividad (log), por ejemplo. Si vemos saltos en la secuencia de IDs, no sabemos si es que son "normales" o es que tal vez alguien ha eliminado registros para borrar las huellas de alguna operación.

SELECT SEC_MI_SECUENCIA.nextval FROM dual; 

=> 3609

2. Función CURRVAL

Esta alternativa permite consultar el último valor que devolvió la secuencia, pero sin generar uno nuevo. Es decir, por muchas ejecuciones que hagamos, siempre nos va a devolver el mismo valor.

select SEC_MI_SECUENCIA.currval from dual;

=> 3609

select SEC_MI_SECUENCIA.currval from dual;

=> 3609

Dicho esto, la solución a mi problema es fácil. Veo en los datos que hay registros con un ID ya coincidente con el próximo que generará la secuencia. Así que obtengo el máximo, que resulta ser

select max(id) from SEC_MI_SECUENCIA;

==> 8596

Así que voy a ALTERAR mi secuencia para que genere números a partir del 8600. Para ello, debo especificar un incremento igual a la diferencia entre el valor actual y el deseado. En mi caso, 8600 - 3609 = 4991. Así que hay que alterar la secuencia DOS VECES: una para poner un incremento de 4991, a continuación obtenemos el siguiente valor, y después volvemos a alterar la secuencia para poner el incremento en 1. Así:

ALTER SEQUENCE SEC_MI_SECUENCIA INCREMENT BY 4991;

SELECT SEC_MI_SECUENCIA.nextval FROM dual;

ALTER SEQUENCE SEC_MI_SECUENCIA INCREMENT BY 1;

Tras esto, ya hemos comprobado que la inserción no da problemas.

Hasta que alguien vuelva a tocar los datos...

jueves, 28 de julio de 2016

La crème de la crème (consultas TOP-N en Oracle)

En esta entrada hablaba de cómo seleccionar las N primeras filas de una tabla. En todos los casos (Informix, SQL Server, SQLite, Oracle), hacía una consulta básica y nos quedábamos con los 10 primeros resultados. Las filas en una tabla relacional no están ordenadas, por definición, lo cual significa que la consulta nos da las N primeras filas aleatorias, es decir, sin ordenar.

Pero la cosa cambia un poco si las queremos ordenadas, es decir los mejores resultados, las mejores notas, los mejores salarios, la crème de la crème... (o los peores).

Queremos los resultados crème de la crème

Esto significa sacar las N filas primeras (o mínimas) o las N filas últimas (o máximas), lo que se denomina a veces consultas TOP-N (TOP-N queries, por si queréis buscarlo en inglés).

En el caso de SQLite3 podíamos poner la cláusula LIMIT después del ORDER BY, como se explicaba en aquella entrada. Pero en ORACLE no existe la cláusula LIMIT, así que habrá que hacerlo de alguna otra manera.

En principio, utilizando la columna "mágica" ROWNUM, si hacemos lo siguiente:

SELECT * FROM TABLA WHERE ROWNUM <= 100

estamos obteniendo 100 filas aleatorias. Uno podría pensar que entonces, para obtener las TOP-100 filas bastaría con añadir una condición ORDER BY, tal que así:

SELECT * FROM TABLA WHERE ROWNUM <= 100 ORDER BY CAMPO

Pero eso no funcionaría. Lo que nos estaría dando son 100 filas aleatorias, y una vez seleccionadas (y no antes), nos las mostraría ordenadas por el CAMPO indicado. Pero eso no significa que nos esté dando las 100 filas PRIMERAS (según en el orden indicado) de la tabla. El problema es que el valor de ROWNUM se está asignando justo al seleccionar la fila, y la operación ORDER BY se aplica después.

Así pues, la forma correcta de hacerlo en Oracle es intercalar una SELECT dentro de otra:

SELECT * FROM (la-consulta-original) WHERE ROWNUM <= 100

Es decir, para el caso que nos ocupa:

SELECT * FROM (SELECT * FROM TABLA ORDER BY CAMPO) WHERE ROWNUM <= 100


Ale, problema resuelto. A seguir tecleando.

--

Nota: no confundir ROWNUM con ROWID. Ambas son columnas que asigna ORACLE automáticamente, pero no significan lo mismo.

Si queréis una explicación muy buena y bastante detallada acerca de la diferencia entre ROWNUM y ROWID y cómo utilizar ROWNUM para consultas TOP-N y para resultados paginados, echadle un vistazo a este artículo

http://www.epidataconsulting.com/tikiwiki/tiki-read_article.php?articleId=63

martes, 19 de julio de 2016

Codificación de caracteres (charset) en una BD Oracle

Necesitaba saber cuál es el CHARSET que se está utilizando en una BD Oracle. Con la sentencia

SELECT * FROM NLS_DATABASE_PARAMETERS;

podremos saber no sólo la codificación, sino otros parámetros interesantes como el idioma, los separadores decimales y de miles, el formato de fecha y hora, la versión de la BD, el símbolo de moneda y algunas cosas más...


viernes, 12 de junio de 2015

Segundo portlet con Liferay: listar una tabla (parte 2 de 2)

Bueno, por diversos motivos he tenido que estar parado un tiempo sin poder actualizar el blog, lo siento mucho. Así que voy a ver si ahora puedo poco a poco volver a la normalidad y hacer las entradas de forma más frecuente.

Continuamos con la creación de un portlet que consulta a una BD Oracle y nos muestra los datos en una simple tabla HTML.

Enlace a la primera parte.

Recordemos que lo último que habíamos hecho era incluir el driver de Oracle en nuestro proyecto, así que ya podemos pasar a establecer la conexión con la BD.

5. Establecer la conexión

Para crear la conexión, necesitamos un objeto de la clase Connection. Esta clase se encuentra en el paquete java.sql, así que añadiremos estas líneas al código:

    import java.sql.Connection;
    ...
   
    //conectar
    Connection conOracle = null;
    conOracle = this.getConexionOracle();


También necesitaremos otras clases de este paquete, así que las añadiremos:

    import java.sql.DriverManager;
    import java.sql.SQLException;
    import java.sql.Statement;
    import java.sql.ResultSet;


Una opción más cómoda sería haber importado todo el paquete java.sql con una única instrucción, así:

    import java.sql.*;
   
Pero yo prefiero especificar individualmente cada clase (si fueran muchísimas no me complicaría la vida e importaría todo el paquete, pero en este caso son pocas). De esta manera, hacemos explícito el conocimiento de las clases que estamos importando.

Para conectar con un servidor Oracle, necesitamos los siguientes datos: servidor (nombre o dirección IP), puerto (por defecto, 1521), nombre del esquema, usuario y la clave. Si tenéis claro todo esto, el método para obtener la conexión quedaría algo así (he borrado los datos específicos de mi instalación, naturalmente):

    private Connection getConexionOracle() {
        String
            servidor = "xx",
            puerto   = "1521",
            esquema  = "xx",
            passBD = "xx",
            usuario = "xx";
        String cadenaBD = "jdbc:oracle:thin:@" + servidor + ":" + puerto + ":" + esquema;
        Connection conOracle = null;
        try {
            DriverManager.registerDriver (new oracle.jdbc.driver.OracleDriver());
                conOracle = java.sql.DriverManager.getConnection(cadenaBD, usuario, passBD);           
        } catch (SQLException e) {
            e.printStackTrace();
            System.out.println("Error en getConexionOracle() : " + e.getMessage());
        }
        return conOracle;
    }


OJO: esto de poner en el propio código Java los datos de la conexión probablemente no es la forma más adecuada de hacerlo. De momento lo dejaremos así por simplicidad de comprensión, pero no es lo más recomendable. Sería mejor configurar la conexión a nivel del contenedor de portlets (Tomcat en nuestro caso, Javaboss... ) y desde el código Java obtener la conexión.

6. Realizar la consulta

Una vez obtenida la conexión, ya está hecho lo más difícil. Ahora tan sólo nos queda realizar la consulta, lo cual podemos hacer con el código que se ve a continuación

    //recuperar datos
    Statement orclStmt = conOracle.createStatement();
    String sql = "select campo1, campo2 from tabla order by campo1 ";
    orclResult = orclStmt.executeQuery(sql);


Como vemos, se utiliza el método createStatement del objeto conOracle y el objeto Statement devuelto nos permite ejecutar la consulta correspondiente.

El objeto oraclResult es de tipo java.sql.ResultSet. Como véis, no lo he declarado en estas líneas, y eso se debe a que voy a poner todo este código dentro de un bucle try/catch, ya que los métodos createStatement y executeQuery pueden lanzar algunas excepciones y debemos atraparlas. Por ello, declararé las variables orclResult y la variable conOracle antes de este bloque, así:

public String recuperarTablaHTML() {
    String res = "<table border=1>";
   
    Connection conOracle = null;
    ResultSet orclResult = null;
    try {
        //conectar
        conOracle = this.getConexionOracle();

        //recuperar datos
        Statement orclStmt = conOracle.createStatement();
        String sql = "select campo1, campo2 from tabla1 order by campo1 ";
        orclResult = orclStmt.executeQuery(sql);


Nuestro código va tomando forma.

7. El bucle de procesamiento

Una vez obtenido el resultado, ya sólo nos queda ir recorriendo el conjunto de registros del resultado. Algo que podemos hacer así:

    while (orclResult.next()) {
        String campo1 = orclResult.getString("campo1");
        String campo2 = orclResult.getString("campo2");
        res += "<tr>";
        res += "<td>" + campo1 + "</td>";
        res += "<td>" + campo2 + "</td>";
        res += "</tr>";
        this.numResultados++;
    }


También hemos introducido en el bucle un contador del número de registros procesados, como puede verse en la última línea dentro del bucle.


8. Mostrar los resultados

Bueno, pues hecho todo lo anterior, sólo nos queda regresar al fichero view.jsp y añadir el código para mostrar el resultado.

Fig. 17. Mostrando los resultados en la vista del portlet

Ahora nos vamos al portal y comprobamos si todo funciona como debería:


Fig. 18. Ejecutando el portlet en nuestro portal


Bueno, parece que sí. Así que ya podemos dar por terminada esta entrada.

miércoles, 22 de abril de 2015

Segundo portlet con Liferay: listar una tabla (parte 1 de 2)

Hasta ahora hemos visto cómo crear un portlet muy básico que básicamente mostraba un mensaje en la página y alguna información del usuario que ha iniciado la sesión en el portal.

Vamos ahora a crear un nuevo portlet con un comportamiento un pelín más interesante, que acceda a una base de datos (Oracle, en este caso) y que muestre los datos de una consulta sobre una tabla. Lo llamaremos "ListarTabla" (olé ahí, derroche de imaginación eligiendo nombres ;-). La tabla que utilizaremos tiene esta estructura:

CREATE TABLE TABLA1
(
   ID varchar2(10) PRIMARY KEY NOT NULL,
   CAMPO1 varchar2(100),
   CAMPO2 varchar2(100)
);

Y estos datos:

INSERT INTO tabla1 VALUES(1, 'ENCARGADO DEL BOCADILLO', 'PEPE GOTERA')
INSERT INTO tabla1 VALUES(2, 'PROFESORA DE BAILE', 'JESSICA ALBA')
INSERT INTO tabla1 VALUES(3, 'ASESOR DE IMAGEN', 'LA PANTOJA DE PUERTO RICO')
INSERT INTO tabla1 VALUES(4, 'CONFESOR', 'COMISARIO TORRENTE')

Comencemos, pues.

1. Crear el portlet

Si no sabes cómo crear un portlet, a lo mejor te es útil echar antes un vistazo a esta entrada: Primer portlet con Eclipse y Liferay.

Utilizaremos el botón de Liferay de la barra de herramientas, y dentro de él la opción "New Liferay Plugin Project"
Fig 1. Creando el portlet "Listar Tabla"

Dejamos las opciones por defecto

Fig. 2. Trabajaremos con el framework MVC

Y tras pulsar Finish se nos debería haber creado la siguiente estructura de carpetas y ficheros

Fig. 3. Estructura de ficheros para el portlet "Listar Tabla"

2. Mostrar datos del usuario y preparar el sitio donde mostrar los resultados

Aunque esto no es necesario, quiero mostrar la información del usuario, como describimos en una entrada anterior, Objetos implícitos en portlets Liferay, así que añadiré el código correspondiente al fichero view.jsp. También añadiremos el sitio donde se mostrarán los datos procedentes de la consulta.

Fig. 4. Preparando el espacio donde se mostrará el resultado de la consulta (línea 30)

3. Crear una clase para acceder a los datos


Ahora viene lo interesante. Para facilitar la legibilidad del código de view.jsp, delegaremos la responsabilidad de acceder a los datos y convertirlos en una tabla HTML a una clase Java que posteriormente invocaremos desde esta página. Así, el fichero view.jsp se limitará a invocar las funciones de esta clase y su código será bastante reducido y limpio.

Esta clase, por cuestiones de organización, será conveniente que esté en un paquete específico. Si no se especifica un paquete concreto, la clase pertenece al paquete por defecto (default), cosa que no se recomienda.


Fig. 5. El uso del paquete 'default' no se recomienda

Así que lo mejor será que creemos antes el paquete que la contendrá. Le pondremos de nombre "accesoDatos" (Eclipse recomienda que los paquetes empiecen con minúscula, aunque esto es más bien una convención Java, no un requisito imprescindible). Para crear el paquete, nos vamos al menú File / New / Package


Fig. 6. Nuevo paquete

Le damos el nombre que hemos dicho, y le indicamos a Eclipse que la carpeta que contendrá los fuentes colgará de WEB-INF/src

Fig. 7. Creando el paquete "accesoDatos"

Tras esto, ya podemos ver en el Package Explorer que el nuevo paquete se encuentra en nuestro proyecto.

Fig. 8. El paquete recién creado

Ahora ya podemos crear la nueva clase dentro de ese paquete. Para ello, hacemos clic con el botón derecho sobre el paquete en el Package Explorer y seleccionamos New / Class


Fig. 9. Creando la nueva clase

Le pondremos de nombre "GestorDatos"

Fig. 10. La clase GestorDatos dentro del paquete accesoDatos

Para este ejemplo, utilizaremos una técnica que podríamos denominar "artesanal". Básicamente, consistirá en que el Gestor de Datos realizará una conexión a la base de datos, recuperará los registros que nos interesan, y a continuación los irá recorriendo en un bucle, construyendo una tabla HTML que irá almacenando en una cadena de texto. Esta cadena será la que devuelva al código invocante (el de view.jsp), que lo único que hará será mostrar esta tabla sin más.

Como digo, este método es muy primitivo, no se utilizan plantillas ni controles de interfaz de usuario, no se paginan los resultados, ni se pueden ordenar, ni ná de ná... Simplemente, se recuperan datos y se muestran. Pero esto es suficiente para ilustrar sin mayores complicaciones el proceso básico de conectarse a una base de datos y hacer 'algo' con los datos recuperados. Es mejor ir dando pequeños pasos, así nos concentramos en un aspecto cada vez.

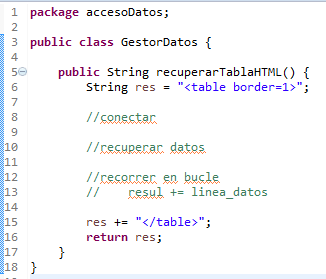
Bueno, pues manos a la obra. La clase GestorDatos va a contener un único método público que será el que devuelva la tabla HTML. Su esquema será algo así:


Fig. 11. Estructura del método que devolverá la tabla HTML

Las acciones de conectar y recuperar datos se codificarán en dos métodos privados de esta clase, que servirán de apoyo al método público. Además, definiremos también un método público para devolver el número de registros recuperados (con la correspondiente variable privada para almacenar este dato).

4. El driver de Oracle

Como dije, voy a sacar los datos de una BD Oracle. Por eso, necesito el driver de Oracle, que descargaremos de la web oficial (http://www.oracle.com/technetwork/database/features/jdbc/index-091264.html). Imagino que tendréis que registraros con un email válido, en su momento yo tuve que hacerlo. Este driver es un fichero de nombre ojdbcXX.jar. El XX depende de la versión que os bajéis, lo cual, a su vez, depende de la versión del sistema operativo y de la versión del motor de la base de datos. Si no tenéis clara la versión del motor de Oracle, aquí podéis ver cómo se averigua. En mi caso, el fichero se llama ojdbc141.jar.

Para que este driver esté disponible en nuestro proyecto, hay que incluir la referencia en el subdirectorio WEB-INF/lib. Para ello, podemos hacer clic con el botón derecho del ratón sobre la carpeta "lib" que cuelga de WEB-INF y luego elegir "Import..." del menú contextual.


Fig. 12. Vamos a añadir el fichero JAR con el driver de Oracle

Para elegir el origen de la importanción desplegamos "General" y dentro de ella elegimos "File System" y pulsamos Next.

Fig. 13. Vamos a seleccionar un fichero del disco

Y en el siguiente diálogo, le indicamos la ruta donde tenemos ese fichero. Nos dará la opción de elegir qué ficheros de la carpeta seleccionada queremos importar. En este caso, sólo he marcado la biblioteca con el driver de acceso a Oracle, como se ve en la figura.

Fig. 14. Importamos solamente el fichero con el driver de Oracle

Tras pulsar Finish, podemos comprobar que ya debe aparecer en el árbol de nuestro proyecto esa biblioteca colgando del subdirectorio WEB-INF/lib

Fig. 15. La biblioteca con el driver de Oracle ya está referenciada en nuestro proyecto

Lo que ha hecho Eclipse internamente ha sido simplemente copiar el fichero indicado dentro del subdirectorio correspondiente, lo que podemos ver si con un explorador de archivos del sistema operativo echamos un vistazo a la carpeta WEB-INF/lib. Allí aparece el fichero que hace un momento no estaba. Por eso, otra forma más rudimentaria de importar el fichero en nuestro proyecto podría haber sido copiar manualmente este fichero.


Fig. 16. La biblioteca importada se ha copiado a la carpeta lib de nuestro proyecto


Bien, hasta aquí la primera parte de esta entrada. En la siguiente entrada completaremos la tarea.

lunes, 9 de marzo de 2015

Buscando desesperadamente a Susan... digoooo... un gestor de BD Oracle

Resulta que últimamente en el curro tengo que lidiar con bases de datos Oracle, cosa que había hecho hasta ahora muy poco (algún contacto puntual sin mayor trascendencia, algún cursillo básico enseñando SQL básico sobre Oracle y... poco más).

Pero ahora se trata de trabajar a diario con algunas BD Oracle. Para ello, el primer paso es proveerme de una buena herramienta de administración de Oracle. Hasta hace unas semanas, la única herramienta que conocía era TOAD que, a pesar de haberla utilizado de forma esporádica, hay que reconocerle que es muuuuuy, pero que muuuuy completa. Tiene una cantidad de características impresionante. Sólo tiene una pega... es de pago. No obstante, si alguien quiere probarla, podéis descargar una versión de evaluación por 30 días.
http://software.dell.com/products/toad-for-oracle/software-downloads.aspx

Si tu organización puede permitírselo, mi recomendación es comprarla. Me parece muy bien pagar por un buen software (ahora bien, no he mirado el precio, así que no sé si se pasan o no).

Sin embargo, en mi caso esto no era una opción. Así que yo busco una aplicación gratuita (si ya fuera libre, miel sobre hojuelas, pero tampoco me obsesiona esto). Tras el habitual proceso de googleo, investigación, descargas, instalaciones, configuración y desinstalaciones, me he quedado con tres candidatas. Bueno, quedado no es la palabra, ya que aún no me he decantado por una:

  • TORA [http://torasql.com/]: tiene buena pinta "la publi", pero, lamentablemente, no he conseguido hacerla funcionar. Al parecer, no soy el único, parece que no es tan fácil hacerla funcionar [http://sourceforge.net/p/tora/discussion/52737/thread/bc088bb4/]. Será cuestión de dedicarle más tiempo. Pero cuando le has dedicado un rato y no le has sacado punta, la verdad es que te aburres y te apetece dejarla y probar otra. Probablemente vuelva a dedicarle algún rato más, ya veremos. Si alguien ha conseguido hacerla funcionar en un Windows7 64 bits, por favor, que me diga cómo.


- SQuirreL SQL [http://squirrel-sql.sourceforge.net/]. Esta he conseguido hacerla funcionar rápidamente, y tiene buena pinta. Aún no la he probado mucho, pero ya veremos. Está hecha en Java, lo que se le nota un poco en rendimiento (algunas exportaciones de tablas gordas han sido un poco lentas), pero tampoco pienso andar moviendo grandes bloques de datos frecuentemente, así que probablemente me valga. Una ventaja es que sólo ocupa 56MB, que no es una barbaridad para los tiempos que corren. Como podéis ver en el menú contextual de la imagen, un montón de opciones para exportar a CSV, Excel, HTML... y otras cosas útiles.


- Y por último, SQL Developer. Esta herramienta, recomendada por un compañero, la proporciona Oracle gratuitamente [http://www.oracle.com/technetwork/developer-tools/sql-developer/downloads/index.html] y también va sobre la JVM, así que (los prejuicios pesan mucho, pero es que cuando son fundados...) será cuestión de evaluarla y ver qué tal. Un poco mamotreto sí que es (casi 500MB una vez descomprimida), pero mi intención es probarla.


Bueno, ¿hay alguna herramienta que conozcáis y que me recomendariais en lugar de estas? Cualquier información será muy bienvenida.

lunes, 16 de febrero de 2015

Oracle, no me gusta que intentes colármela

Que una empresa proporcione actualizaciones es algo meritorio, algo a valorar positivamente, pues demuestra que se preocupan por mantener en un buen estado su software, que éste está vivo y que en la empresa no son unos dejaos. Cierto que a veces las actualizaciones son tan frecuentes que pueden llegar a ser algo molestas (¿seguro que son necesarias con taaaanta frecuencia?), pero bueno, podríamos decir que es un mal menor. Si hay que actualizar, porque es bueno para la seguridad y/o funcionalidad, pues se actualiza y punto.

Ahora bien, que en esas actualizaciones intenten colarme otras aplicaciones que nada tienen que ver con el software principal, me molesta, pues es una falta de respeto y un intento de engañarme. Es como si el fontanero viene a mi casa a arreglarme el grifo y de paso, en cuanto miro para otro lado, intenta ponerme un filtro o una alcachofa en el grifo del baño que yo no le he pedido. No lo quiero ni aunque sea "gratis" (normalmente estas cosas tampoco es que sean gratis, como mínimo te tocará comerte tu buena ración de publicidad). Ese software va a repercutir en mi sistema, de diferentes maneras. ¿Por qué no me preguntas y decides que yo tenga que marcar el "SÍ, QUIERO", en vez de darme la opción ACEPTADA por defecto y que sea yo quien tenga que estar atento a desmarcarla? ¿De verdad una empresa seria ve bien este juego sucio?

Esto ocurre con las actualizaciones de Java que hace Oracle, que así, como quien no quiere la cosa, prueban a ver si cuela y por despiste le doy a "siguiente, siguiente..." y me trago la barra Ask del navegador que, yo no sé si alguien la utiliza, pero yo desde luego no la quiero.


Para mí, es un truco sucio. Y que lo utilice Oracle, una de las grandes de la informática, me molesta. Punto negativo para ellos.

lunes, 2 de febrero de 2015

Cómo saber la versión de ORACLE

Resulta que me han dado las credenciales de acceso a una BD Oracle, pero no sé qué versión del motor del SGBD de Oracle se está utilizando. ¿Cómo puedo saberlo?

Pues así (gracias a mi compañero M por esta información):


select * from sys.v_$version

También se puede saber con una versión ligeramente distinta, tecleando algunos caracteres menos, lo cual siempre viene bien para los "gandules" como yo:

select * from v$version


Según veo, v$version y sys.v_$version son sinónimos para una vista que sólo tiene una columna (de nombre BANNER) donde hay 5 líneas con información no sólo de la versión del motor, sino de otros componentes de la Base de Datos:  entorno de desarrollo PL/SQL, protocolo TNS (conexión a la BD), la biblioteca de soporte de idioma (NLSRTL = National Language Support Runtime Library), etc.

En la versión "larga", se puede ver que la vista pertenece al usuario "SYS", uno de los usuarios especiales del sistema. El esquema (usuario) SYS contiene las vistas y tablas básicas del diccionario de datos de la base de datos, y las tablas de este esquema se manipulan con las operaciones que se van realizando en la base de datos.

Las dos vistas indicadas para consultar la versión del motor tienen permiso de SELECT para todos los usuarios (PUBLIC)


Pues nada, ahí queda la cosa, por si alguien lo necesita.

viernes, 13 de enero de 2012

SQL - Seleccionar sólo las primeras N filas

El otro día metí la pata haciendo un SELECT genérico de una tabla de la que desconocía el tamaño. El procesador se puso casi al 100% durante 5 minutos, y el disco duro no dejaba de rascar. Los usuarios que compartían (sufrían) conmigo el acceso a la BD estuvieron experimentando un rendimiento pésimo durante esos 5 minutos (bueno, los pocos que intentaron trabajar en ese período), que a mí se me hicieron eternos. El problema es que la tabla tenía casi 2 millones de registros y esto fue er... bueno... "un poco" pesado. Encima, el resultado fue a una página web, así que os podéis imaginar el tamaño del "ascensor" (el recuadro) de la barra de desplazamiento. Casi no se podía pinchar en él de pequeño que se quedó.

El caso es que me interesaba simplemente ojear el contenido de esa tabla, me hubiera bastado con recuperar unos pocos registros, digamos, unos 100 para hacerme una idea de su contenido. Bueno, pues eso se puede hacer sin necesidad de poner filtros a los datos (cosa que en su momento no podía hacer pues no tenía ni idea de los campos y datos de la tabla).

En ORACLE
SELECT * FROM TABLA WHERE ROWNUM <100

En MS SQL Server y en SYBASE

SELECT TOP 10 * FROM TABLA

En INFORMIX
SELECT FIRST 100 * FROM TABLA


Actualización 02/09/2014 para incluir SQLite3, que me ha hecho falta hoy. Hay que añadir LIMIT(N) al final de la consulta

En SQLite3
SELECT * FROM TABLA LIMIT(100)

Si hubiera cláusulas WHERE u ORDER BY, hay que poner la opción LIMIT al final de todo, o sea:

SELECT * FROM TABLA WHERE CONDICION ORDER BY CAMPO LIMIT(100)
Related Posts Plugin for WordPress, Blogger...